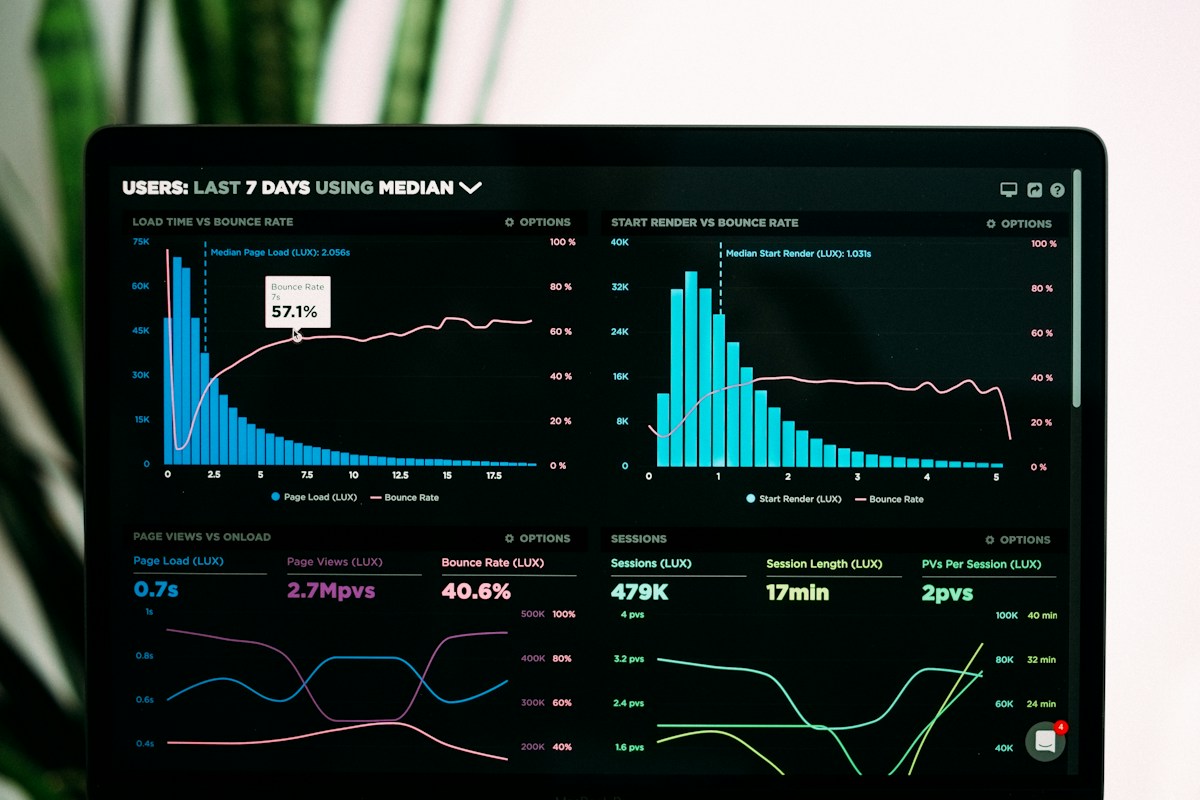
Administrar servidores e aplicações em produção sem visibilidade em tempo real é como pilotar um avião às cegas. Descobrir que o disco encheu, que a memória RAM esgotou ou que a CPU bateu 100% apenas após os usuários reclamarem de lentidão custa tempo, dinheiro e reputação. Para antecipar problemas e garantir alta disponibilidade, a combinação de Prometheus e Grafana tornou-se o padrão ouro da indústria de infraestrutura e DevOps.
O Prometheus é um banco de dados de séries temporais (TSDB) ultrarrápido projetado para coletar métricas periodicamente, enquanto o Grafana é a plataforma de visualização de dados mais elegante e poderosa do mercado. Quando combinados com o Node Exporter dentro de contêineres Docker, eles formam uma pilha completa de observabilidade com dashboards dinâmicos e alertas automatizados.
Neste tutorial definitivo passo a passo, você aprenderá a estruturar e subir toda essa stack com Docker Compose, configurar o arquivo de raspagem de métricas (scrape), conectar o Grafana ao Prometheus e importar um dashboard profissional de monitoramento em poucos minutos.
A Arquitetura da Stack de Monitoramento
A pilha é composta por três componentes que trabalham em sincronia contínua:
- Node Exporter (O Coletor): Um agente leve que roda no host e expõe centenas de métricas de hardware e do kernel Linux (temperatura, carga de CPU, memória livre, tráfego de rede e IOPS de disco) em um endpoint HTTP simples na porta 9100.
- Prometheus (O Armazenador): Faz requisições periódicas (a cada 15 segundos, por exemplo) para o Node Exporter, coleta as métricas e as grava de forma comprimida no seu banco de séries temporais.
- Grafana (O Visualizador): Conecta-se ao Prometheus como fonte de dados (Data Source), executa consultas via linguagem PromQL e renderiza gráficos, medidores e mapas de calor em tempo real.
Links Oficiais e Recursos
Utilize sempre a documentação e repositórios oficiais dos projetos:
- Prometheus: Acessar Site Oficial do Prometheus
- Grafana: Acessar Site Oficial do Grafana
- Node Exporter: Repositório Oficial do Node Exporter no GitHub
- Catálogo de Dashboards da Comunidade: Grafana Dashboards
Estrutura de Pastas e Arquivos de Configuração
No seu servidor Linux, crie a estrutura de diretórios para organizar as configurações e volumes persistentes:
mkdir -p /opt/monitoring/prometheus
cd /opt/monitoring
1. Criando o Arquivo de Configuração do Prometheus
Crie o arquivo prometheus/prometheus.yml:
global:
  scrape_interval: 15s      # Intervalo padrão de coleta de métricas
  evaluation_interval: 15s  # Intervalo de avaliação de regras de alerta

scrape_configs:
  - job_name: 'prometheus'
    static_configs:
      - targets: ['localhost:9090']

  - job_name: 'node_exporter'
    static_configs:
      - targets: ['node-exporter:9100']
2. Criando o docker-compose.yml
No diretório /opt/monitoring, crie o arquivo docker-compose.yml unindo os três serviços em uma rede bridge dedicada:
services:
  prometheus:
    image: prom/prometheus:latest
    container_name: prometheus
    restart: unless-stopped
    volumes:
      - ./prometheus/prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - prometheus_data:/prometheus
    command:
      - '--config.file=/etc/prometheus/prometheus.yml'
      - '--storage.tsdb.path=/prometheus'
      - '--storage.tsdb.retention.time=15d'
      - '--web.enable-lifecycle'
    ports:
      - "9090:9090"
    networks:
      - monitoring

  node-exporter:
    image: prom/node-exporter:latest
    container_name: node-exporter
    restart: unless-stopped
    volumes:
      - /proc:/host/proc:ro
      - /sys:/host/sys:ro
      - /:/rootfs:ro
    command:
      - '--path.procfs=/host/proc'
      - '--path.rootfs=/rootfs'
      - '--path.sysfs=/host/sys'
      - '--collector.filesystem.mount-points-exclude=^/(sys|proc|dev|host|etc)($$|/)'
    ports:
      - "9100:9100"
    networks:
      - monitoring

  grafana:
    image: grafana/grafana:latest
    container_name: grafana
    restart: unless-stopped
    ports:
      - "3000:3000"
    volumes:
      - grafana_data:/var/lib/grafana
    environment:
      - GF_SECURITY_ADMIN_USER=admin
      - GF_SECURITY_ADMIN_PASSWORD=admin
      - GF_USERS_ALLOW_SIGN_UP=false
    networks:
      - monitoring

networks:
  monitoring:
    driver: bridge

volumes:
  prometheus_data:
  grafana_data:
Iniciando a Stack
Com os arquivos salvos, inicialize todos os contêineres executando:
docker compose up -dVerifique se os três contêineres estão com status healthy / Up através do comando docker compose ps.
Configurando o Grafana e Importando Dashboards
Abra seu navegador e acesse http://ip-do-seu-servidor:3000:
- Faça login com usuário
admine senhaadmin(o sistema solicitará a criação de uma nova senha forte imediatamente). - Adicionar o Prometheus como Data Source:
- Vá no menu lateral em Connections > Data Sources.
- Clique em Add data source e selecione Prometheus.
- No campo Prometheus server URL, digite
http://prometheus:9090(graças à rede interna do Docker, você pode usar o próprio nome do contêiner!). - Role até o final da página e clique em Save & test. Um aviso verde com “Successfully queried the Prometheus API” confirmará a conexão.
- Importar o Dashboard Completo do Servidor (Node Exporter Full):
- No menu lateral, vá em Dashboards > New > Import.
- No campo Import via grafana.com, digite o código 1860 (o clássico e mais completo dashboard comunitário de Linux) e clique em Load.
- Na opção de seleção de fonte de dados no rodapé, aponte para o Prometheus recém-configurado e clique em Import.
Instantaneamente, você terá acesso a dezenas de gráficos dinâmicos mostrando a temperatura da CPU, taxas de leitura e escrita nos discos NVMe/SSD, saturação de banda de rede e consumo de memória RAM por processo!
Configurando Alertas Inteligentes
O Grafana inclui o Grafana Alerting nativo. Você pode criar regras automáticas de monitoramento:
- Alerta de Disco Cheio: Dispare uma notificação se a partição raiz ultrapassar 85% de uso contínuo por mais de 10 minutos.
- Alerta de Servidor Offline: Envie um aviso imediato se a métrica
up == 0for detectada no Node Exporter. - Canais de Contato (Contact Points): O Grafana entrega notificações diretamente no Telegram, canais do Discord, webhooks do Slack ou e-mail corporativo sem exigir softwares adicionais.
Conclusão
Com o Prometheus e o Grafana rodando em contêineres Docker isolados, sua infraestrutura ganha visibilidade completa de nível corporativo com baixíssimo consumo de recursos. Monitorar métricas proativamente e antecipar gargalos antes que eles virem incidentes reais é o divisor de águas entre uma gestão amadora e uma operação profissional.